¿Qué es la Ventana de Contexto en una Inteligencia Artificial?
La ventana de contexto es uno de los conceptos fundamentales para entender cómo funcionan los modelos de inteligencia artificial capaces de procesar lenguaje, como los grandes modelos de lenguaje (LLM).
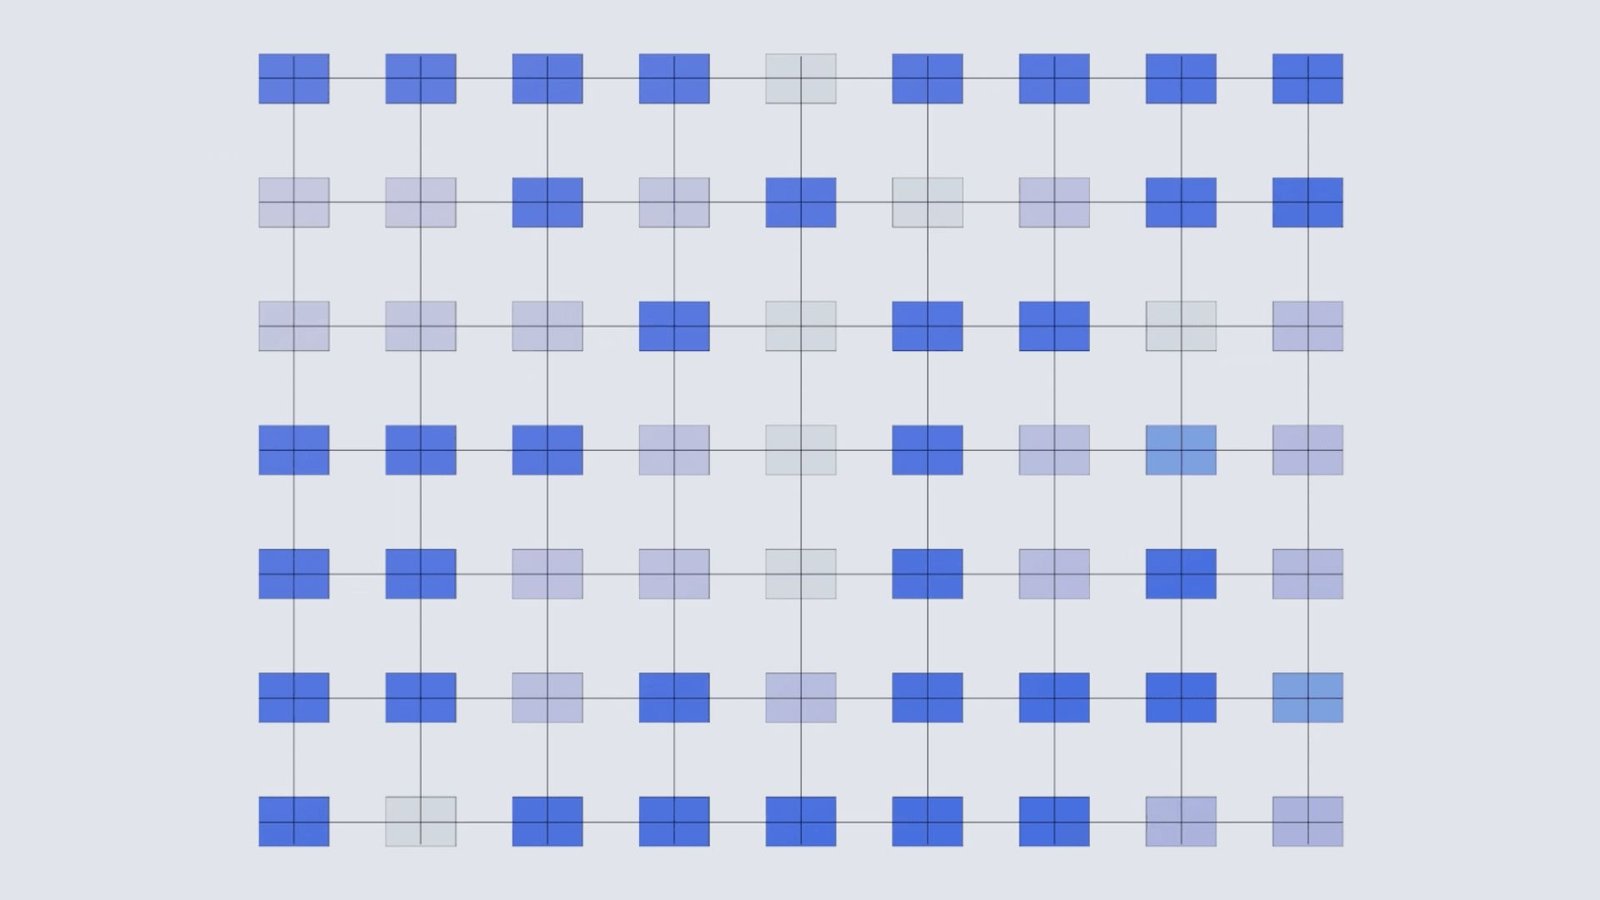
De forma sencilla, la ventana de contexto representa la cantidad máxima de información que un modelo puede tener disponible dentro de una determinada interacción o solicitud. Esta información puede incluir mensajes de una conversación, instrucciones, documentos, fragmentos de código y otros datos que formen parte de la entrada procesada por el modelo.
La capacidad de contexto normalmente se expresa en tokens, y no directamente en palabras o caracteres.
Esto es importante porque los modelos de lenguaje no procesan el texto exactamente de la misma manera que una persona. Antes de ser procesado, el contenido se divide en unidades llamadas tokens. Dependiendo del idioma y del texto, un token puede corresponder a una palabra completa, una parte de una palabra, un signo de puntuación o una combinación de caracteres.
Por eso, cuando se habla de una ventana de contexto de determinado número de tokens, no significa necesariamente que el modelo pueda procesar exactamente la misma cantidad de palabras.
Comprender este concepto ayuda a entender por qué una conversación muy larga, un documento extenso o una gran cantidad de código pueden presentar limitaciones incluso cuando el modelo parece capaz de trabajar con textos complejos.
¿Qué es una Ventana de Contexto?
La ventana de contexto es el límite de tokens que un modelo puede considerar como contexto para producir una respuesta.
Imaginemos que estamos conversando con un modelo de lenguaje y le enviamos un documento, varias instrucciones y una serie de mensajes anteriores. Todo ese contenido forma parte del contexto que el modelo debe procesar.
Si la cantidad total de información supera el límite disponible, el sistema necesita aplicar alguna estrategia para manejar el exceso de contenido. Dependiendo de la aplicación, puede ser necesario eliminar partes anteriores, resumir información, dividir el documento en fragmentos o utilizar mecanismos externos de recuperación de información.
Por eso, una ventana de contexto más grande permite trabajar con más información dentro de una misma interacción, pero no significa automáticamente que el modelo comprenda todo de manera perfecta.
Esta distinción es importante.
Un modelo puede tener una ventana de contexto muy grande y aun así cometer errores, ignorar detalles relevantes o interpretar incorrectamente una parte del contenido.
Contexto no es lo mismo que memoria
Otro punto importante es diferenciar ventana de contexto de memoria.
El contexto corresponde a la información que el modelo tiene disponible para procesar en una determinada solicitud.
La memoria, cuando existe como funcionalidad de un producto, puede utilizar mecanismos diferentes para conservar determinadas informaciones entre conversaciones o sesiones.
Por lo tanto, si una información está fuera de la ventana de contexto disponible para una solicitud, no significa necesariamente que el modelo “la haya olvidado” en el sentido humano. Simplemente significa que esa información no está siendo proporcionada como parte del contexto que está procesando en ese momento.
¿Qué Son los Tokens?
Para comprender la ventana de contexto, primero es necesario entender qué son los tokens.
Los modelos de lenguaje procesan texto utilizando unidades llamadas tokens. Estas unidades no corresponden necesariamente a palabras completas.
Por ejemplo, una palabra relativamente común puede ser representada por un único token, mientras que una palabra más compleja puede dividirse en varias unidades.
La tokenización también depende del idioma, del modelo y de las características del texto.
Esto significa que:
1.000 palabras no equivalen necesariamente a 1.000 tokens.
La relación puede variar considerablemente.
Además, elementos como código de programación, números, URLs, emojis y diferentes idiomas pueden tener patrones de tokenización distintos.
Por eso, cuando una plataforma informa que un modelo admite determinada cantidad de tokens, ese número no debe interpretarse directamente como una cantidad fija de páginas o palabras.
¿Por qué la Ventana de Contexto es Importante?
La ventana de contexto es especialmente importante cuando se trabaja con grandes cantidades de información.
Por ejemplo, un usuario puede pedirle a un modelo que:
- analice un documento extenso;
- compare diferentes archivos;
- revise un proyecto de programación;
- mantenga una conversación larga;
- resuma investigaciones;
- analice contratos;
- extraiga información de grandes conjuntos de textos;
- trabaje con documentación técnica.
En todos estos casos, la cantidad de información disponible en el contexto puede afectar la forma en que el modelo procesa la solicitud.
Una ventana más amplia puede permitir incluir más información en una única interacción.
Sin embargo, más contexto no significa necesariamente mejor respuesta.
Si el contexto contiene información irrelevante, contradictoria o de baja calidad, incluir más contenido puede incluso dificultar la tarea.
Por eso, además del tamaño de la ventana, también importan la calidad, la organización y la relevancia de la información proporcionada.
¿Cómo Funciona la Ventana de Contexto?
Podemos imaginar la ventana de contexto como un espacio de trabajo temporal.
Supongamos que una persona envía al modelo:
- instrucciones;
- un documento;
- algunos ejemplos;
- una pregunta.
Todo ese contenido ocupa espacio dentro del contexto disponible.
El modelo procesa esos elementos para generar una respuesta.
En términos simplificados:
Entrada → Tokenización → Contexto disponible → Procesamiento del modelo → Respuesta
La entrada puede incluir no solamente el mensaje más reciente, sino también otras informaciones que el sistema decida proporcionar al modelo.
En una conversación, por ejemplo, los mensajes anteriores pueden formar parte del contexto. En una aplicación empresarial, también pueden incluirse documentos recuperados de una base de conocimiento.
Cuando el contenido supera el límite disponible, la aplicación debe decidir qué hacer con la información excedente.
¿Qué Ocurre Cuando se Supera el Límite?
Cuando la cantidad de tokens supera la capacidad de contexto de un modelo, no es posible simplemente continuar agregando información indefinidamente.
La forma de manejar esta situación depende de la aplicación.
Algunas estrategias comunes incluyen:
Eliminar información anterior
Una aplicación puede retirar mensajes antiguos de la conversación para liberar espacio.
Resumir el contexto
El sistema puede generar un resumen de información anterior y utilizar ese resumen en lugar de todos los mensajes originales.
Dividir documentos
Un documento grande puede dividirse en fragmentos más pequeños para analizarlos por separado.
Utilizar recuperación de información
En sistemas de RAG (Retrieval-Augmented Generation), por ejemplo, una aplicación puede buscar solamente los fragmentos de información relevantes para una determinada pregunta y enviarlos al modelo.
Esto permite trabajar con bases de conocimiento mucho más grandes que la ventana de contexto disponible en una única solicitud.
¿Una Ventana de Contexto Mayor Siempre es Mejor?
No necesariamente.
Una ventana de contexto más grande permite proporcionar más información al modelo, pero existen otros factores que afectan la calidad de una respuesta.
Entre ellos están:
- calidad de los datos;
- relevancia de la información;
- capacidad del modelo;
- claridad de las instrucciones;
- organización del contexto;
- complejidad de la tarea;
- capacidad del sistema para identificar información importante.
Imaginemos un documento de 500 páginas en el que solamente existe un párrafo relevante para la pregunta.
Simplemente enviar todo el documento puede no ser la estrategia más eficiente.
En determinadas aplicaciones, puede ser mejor localizar primero la información relevante y después proporcionársela al modelo.
Por eso, la gestión del contexto es tan importante como su tamaño.
Desafíos de las Ventanas de Contexto Grandes
Aumentar la capacidad de contexto también presenta desafíos técnicos.
Uno de ellos está relacionado con los recursos computacionales necesarios para procesar grandes cantidades de información.
Dependiendo de la arquitectura y de las técnicas utilizadas, procesar más tokens puede aumentar los requisitos de memoria, procesamiento, tiempo de respuesta y costo.
Además, existe un desafío relacionado con la atención del modelo.
Un modelo puede recibir una gran cantidad de información, pero eso no garantiza que todos los elementos reciban exactamente el mismo nivel de atención durante la generación de la respuesta.
En tareas muy largas, puede ser más difícil identificar cuáles son los fragmentos realmente relevantes.
Por eso, la investigación actual no se concentra únicamente en aumentar la ventana de contexto, sino también en mejorar la eficiencia con la que los modelos utilizan ese contexto.
Ventana de Contexto y Modelos de Lenguaje
La ventana de contexto es especialmente relevante para los Large Language Models (LLM).
Modelos utilizados en asistentes de IA, herramientas de programación, análisis de documentos y sistemas empresariales pueden utilizar el contexto para interpretar las instrucciones y generar respuestas.
Cuanto más compleja sea una tarea, más importante puede ser la capacidad de proporcionar información relevante al modelo.
Por ejemplo, un desarrollador puede querer analizar un proyecto con varios archivos.
En lugar de enviar únicamente una función aislada, podría ser necesario proporcionar información sobre:
- arquitectura del proyecto;
- archivos relacionados;
- dependencias;
- funciones utilizadas;
- mensajes de error;
- requisitos del sistema.
Una ventana de contexto adecuada puede facilitar este tipo de trabajo.
Sin embargo, nuevamente, el tamaño por sí solo no garantiza una comprensión perfecta del proyecto.
Ventana de Contexto, RAG y Bases de Conocimiento
La evolución de la IA también ha generado técnicas para trabajar con información que supera ampliamente el contexto de una única solicitud.
Una de las más conocidas es RAG, o Retrieval-Augmented Generation.
En un sistema RAG, los documentos pueden almacenarse en una base de conocimiento y, cuando el usuario realiza una pregunta, el sistema busca los fragmentos más relevantes.
Después, esos fragmentos se incorporan al contexto enviado al modelo.
De esta manera, el sistema no necesita colocar toda la base de datos dentro de la ventana de contexto.
Un ejemplo sería una empresa que posee miles de documentos internos.
Cuando un empleado pregunta sobre una política específica, el sistema puede localizar los documentos relacionados y proporcionar al modelo solamente los fragmentos relevantes.
Esto permite combinar recuperación de información + generación de lenguaje.
Ejemplos Prácticos
La ventana de contexto tiene aplicaciones en diferentes áreas.
Atención al cliente
Un chatbot puede utilizar el contexto de una conversación para comprender qué problema está intentando resolver el cliente.
Si el contexto es insuficiente, el usuario puede tener que repetir información que ya había proporcionado.
Programación
Los asistentes de código pueden utilizar el contexto de diferentes archivos, funciones y configuraciones para ayudar a analizar o modificar un proyecto.
Análisis de documentos
Una empresa puede utilizar modelos de lenguaje para analizar contratos, informes, manuales o documentos técnicos.
La cantidad de información que puede ser procesada en una única interacción depende, entre otros factores, de la capacidad de contexto del modelo y de la forma en que la aplicación organiza los documentos.
Educación
Un asistente puede utilizar el contexto de una conversación para adaptar una explicación a las preguntas anteriores del estudiante.
Nuevamente, esto no significa que el modelo tenga una memoria humana permanente de todo lo que se habló.
¿Qué Significa Esto para el Usuario?
Comprender la ventana de contexto puede ayudar a utilizar mejor las herramientas de inteligencia artificial.
Cuando se trabaja con una tarea extensa, algunas buenas prácticas son:
- proporcionar información relevante;
- evitar contenido innecesario;
- dividir documentos muy grandes cuando sea conveniente;
- organizar instrucciones de forma clara;
- indicar qué información es prioritaria;
- resumir decisiones importantes;
- utilizar herramientas de recuperación cuando sea necesario;
- verificar respuestas en tareas importantes.
En otras palabras, más información no siempre significa mejor contexto.
Un contexto bien organizado puede ser más útil que un contexto simplemente grande.
El Futuro de las Ventanas de Contexto
La capacidad de contexto de los modelos de lenguaje ha aumentado considerablemente con el desarrollo de nuevas arquitecturas y técnicas de procesamiento.
La tendencia apunta no solamente hacia ventanas cada vez mayores, sino también hacia sistemas capaces de utilizar la información de manera más eficiente.
Esto puede favorecer aplicaciones que trabajen con grandes repositorios de código, documentos extensos, bases de conocimiento y diferentes tipos de información.
Además, la combinación de modelos de lenguaje con herramientas externas, sistemas de recuperación, bases de datos y agentes de IA puede reducir la dependencia de colocar toda la información disponible dentro de una única ventana de contexto.
Por eso, el futuro probablemente no dependa exclusivamente de “cuántos tokens caben”, sino también de cómo los sistemas seleccionan, organizan y utilizan la información relevante.
Conclusión
La ventana de contexto representa la cantidad de información que un modelo de IA puede tener disponible como contexto durante una determinada interacción.
Su capacidad suele expresarse en tokens, que son las unidades utilizadas por el modelo para procesar texto.
Una ventana más grande puede facilitar el trabajo con conversaciones, documentos y proyectos extensos, pero no garantiza por sí sola respuestas más precisas o una mejor comprensión.
La calidad de los datos, la relevancia de la información, las instrucciones y la capacidad del propio modelo también son factores importantes.
Además, tecnologías como RAG permiten trabajar con cantidades de información mucho mayores que las que cabrían directamente en una única ventana de contexto.
Por eso, entender este concepto es fundamental para utilizar mejor las herramientas de inteligencia artificial. En lugar de pensar solamente en cuánto contenido podemos enviar a un modelo, también debemos pensar en qué información es relevante, cómo organizarla y cómo ponerla a disposición del sistema en el momento adecuado.
La evolución de la IA probablemente seguirá ampliando las capacidades de contexto, pero la eficiencia en la gestión de la información será tan importante como el tamaño de la ventana.